Phần 1: Kiến Trúc Hybrid AI & Tự Host vLLM

Phần 1: Kiến Trúc Hybrid AI & Tự Host vLLM

← Chương trước: Executive Summary — Sổ Tay Tối Ưu Hóa SLM | Mục lục Series | Chương tiếp theo: Phần 2: Kỹ Nghệ Dữ Liệu Cho SFT: NEFTune & SemDeDup → Answer-first: Kiến trúc Hybrid AI định tuyến 80% truy vấn có cấu trúc về SLM nội bộ trên vLLM trong 35ms TTFT, chỉ chuyển tiếp 20% bài toán phức tạp lên Frontier LLM qua circuit breaker. Thiết kế này cắt giảm 85% chi phí API hàng tháng và bảo toàn tuyệt đối dữ liệu PII nội bộ. ...
Kubernetes In-Place Pod Resizing Guide

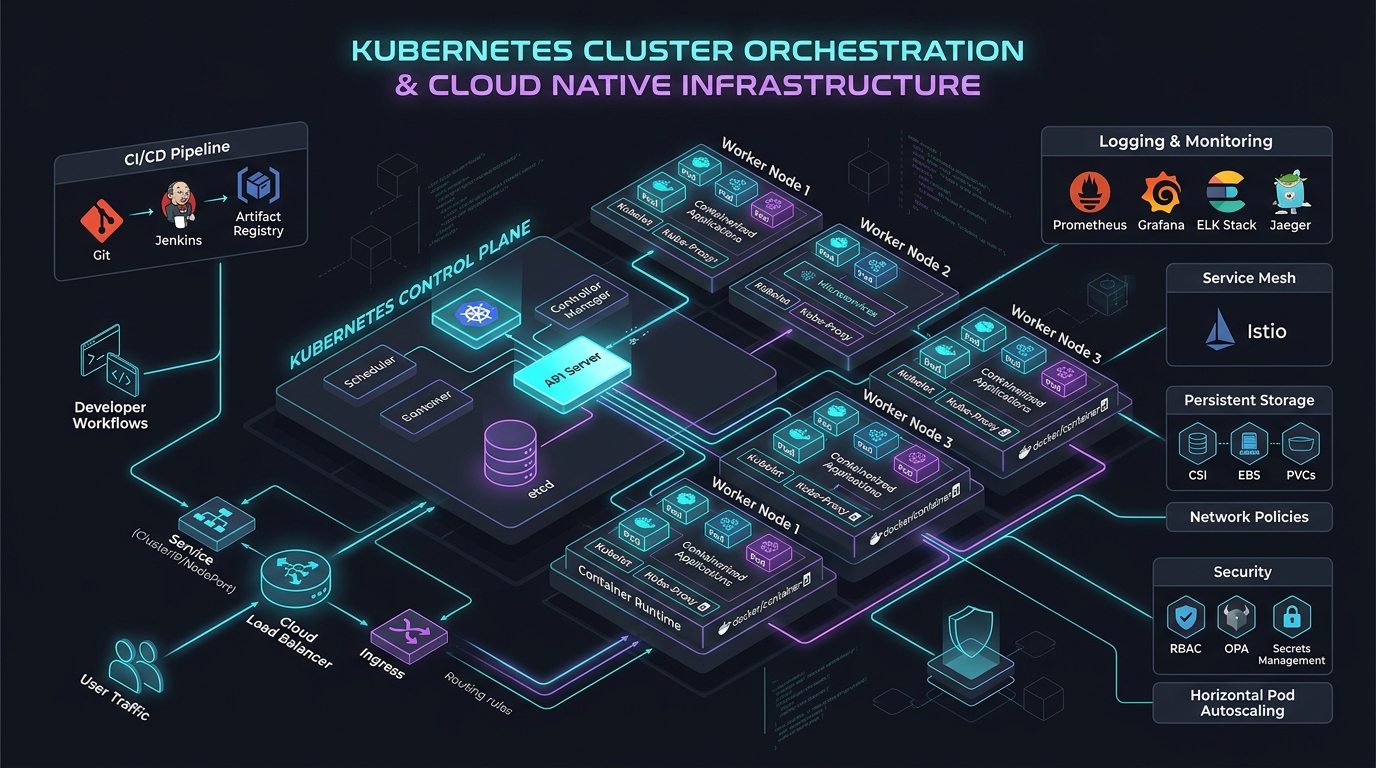
Kubernetes In-Place Pod Resizing: Hướng Dẫn Kỹ Thuật Chuyên Sâu Chuẩn Production

🇬🇧 Read the English version of this article on tanhdev.com Answer-first: In-Place Pod Resizing (chính thức đạt trạng thái Stable/GA từ Kubernetes v1.35) cho phép cập nhật tài nguyên CPU và Memory trực tiếp trên container đang chạy thông qua subresource /resize mà không cần khởi động lại Pod. Tính năng này yêu cầu container runtime hỗ trợ CRI API UpdateContainerResources (containerd ≥ 1.6.9 hoặc CRI-O ≥ 1.25), kết hợp với chế độ VPA updateMode: "InPlace" giúp loại bỏ hoàn toàn tình trạng gián đoạn kết nối, rút ngắn độ trễ cold start của AI inference từ hàng phút xuống còn dưới 1 giây và cắt giảm 40–60% chi phí hạ tầng. ...