🇬🇧 Read the English version of this article on tanhdev.com
Answer-first: Mở rộng quy mô MySQL bền vững đòi hỏi tuân thủ lộ trình 4 cấp độ TPS: (1) Cấp 1 (100–500 TPS) tối ưu hóa nội tại InnoDB Buffer Pool (chiếm 75% RAM vật lý, duy trì hit rate > 95%); (2) Cấp 2 (500–1.500 TPS) loại bỏ truy vấn chậm qua
pt-query-digestvà triệt tiêu Deadlock bằng Optimistic Concurrency Control; (3) Cấp 3 (1.500–3.000 TPS) phân tách Đọc/Ghi qua cụm ProxySQL kẹp cờtransaction_persistent = 1và giải quyết Replication Lag bằng Writeset đa luồng trong MySQL 8.4; (4) Cấp 4 (3.000–10.000+ TPS) bẻ gãy giới hạn ghi bằng Sharding Vitess hoặc di trú không downtime sang TiDB NewSQL tự động phân vùng Region 96MB.
Mở rộng quy mô cơ sở dữ liệu quan hệ (Database Scalability) là một trong những bài toán phức tạp và tốn kém nhất trong kỹ thuật thiết kế hệ thống. Khi một nền tảng thương mại điện tử hoặc fintech phát triển từ 1.000 lên hàng triệu người dùng hoạt động, cơ sở dữ liệu MySQL đơn lẻ nhanh chóng chạm tới trần nhà vật lý: CPU liên tục duy trì ở mức 90%, hàng đợi kết nối (Connection Pool) cạn kiệt, và tỷ lệ cache hit của InnoDB Buffer Pool sụt giảm nghiêm trọng.
Tuy nhiên, sai lầm phổ biến nhất của các đội ngũ kỹ thuật là nhảy cóc kiến trúc: Vội vã áp dụng Sharding phân tán phức tạp khi chưa tối ưu hóa chỉ mục (Indexes), hoặc cố gắng phân tách Đọc/Ghi (Read/Write Splitting) mà không kiểm soát được độ trễ sao chép (Replication Lag), dẫn đến thảm họa đọc dữ liệu cũ (Stale Reads).
Bài viết này cung cấp một lộ trình 4 giai đoạn mở rộng MySQL chuẩn mực công nghiệp — từ việc tinh chỉnh tham số nội tại InnoDB Buffer Pool (100 - 500 TPS), tối ưu hóa câu truy vấn và chỉ mục (500 - 1.500 TPS), gom nhóm kết nối và phân luồng qua ProxySQL (1.500 - 3.000 TPS), cho đến phân mảnh ngang (Vitess Sharding) hoặc di trú sang TiDB NewSQL (3.000 - 10.000+ TPS). Toàn bộ các giải pháp đều đi kèm mã nguồn Go thực chiến và phân tích post-mortem từ môi trường sản xuất.
⚡ Tóm Tắt Kiến Trúc Cốt Lõi (Executive BLUF)
- Phân định rạch ròi 2 chiều mở rộng:
- Read Scaling (Mở rộng Đọc): Tuyến tính và chi phí thấp bằng cách bổ sung Read Replicas kết hợp ProxySQL.
- Write Scaling (Mở rộng Ghi): Phức tạp và đòi hỏi thay đổi kiến trúc thông qua Sharding hoặc chuyển đổi sang Distributed SQL (TiDB).
- Lộ trình 4 cấp độ TPS:
- Cấp 1 (100 - 500 TPS): Tinh chỉnh
innodb_buffer_pool_sizechiếm 70% - 80% RAM vật lý, duy trì hit rate > 95%.- Cấp 2 (500 - 1.500 TPS): Đánh chỉ mục B+Tree tối ưu, xử lý truy vấn chậm qua
pt-query-digest.- Cấp 3 (1.500 - 3.000 TPS): Cấu hình ProxySQL gom nhóm kết nối và phân tách Đọc/Ghi với
transaction_persistent = 1.- Cấp 4 (3.000 - 10.000+ TPS): Sharding với Vitess hoặc chuyển sang TiDB NewSQL tự động phân vùng Region 96MB.
- Chống thảm họa Replication Lag: Cấu hình MySQL 8.0/8.4 với
binlog_transaction_dependency_tracking = 'WRITESET'vàreplica_parallel_workers = 8để kích hoạt cơ chế áp dụng bản ghi song song đa luồng.
1. Bản Đồ Lộ Trình 4 Giai Đoạn Mở Rộng MySQL (The Scaling Ladder)
graph TD
    A["Giai Đoạn 1: Tối Ưu Hóa Cấu Hình Đơn Node\n(100 - 500 TPS)\n• Buffer Pool = 75% RAM\n• Redo Log & Flush Method O_DIRECT\n• Tránh Restart với Dynamic Resizing"] --> B["Giai Đoạn 2: Tối Ưu Hóa Câu Truy Vấn & Chỉ Mục\n(500 - 1.500 TPS)\n• Phân tích pt-query-digest\n• Chặn Full Table Scans\n• Khóa lạc quan (OCC) chống Deadlock"]

    B --> C["Giai Đoạn 3: Phân Tách Đọc/Ghi Qua ProxySQL\n(1.500 - 3.000 TPS)\n• Read Replicas Asynchronous\n• Multiplexing Connection Pooling\n• transaction_persistent = 1"]

    C --> D{"Ngưỡng Quá Tải Ghi:\nĐĩa Master Đạt Trần IOPS NVMe?"}

    D -- Đội Ngũ SRE Mỏng --> E["Giai Đoạn 4A: Di Trú Sang TiDB NewSQL\n(3.000 - 100.000+ TPS)\n• Auto-Partitioning 96MB Regions\n• Phân tán ACID Percolator\n• Không cần sửa mã nguồn SQL"]

    D -- Giữ Nguyên MySQL Thuần --> F["Giai Đoạn 4B: Sharding Bằng Vitess / Middleware\n(3.000 - 50.000 TPS)\n• Thiết kế Sharding Key thủ công\n• Quản lý VSchema phức tạp"]
2. Giai Đoạn 1: Làm Chủ Cơ Chế Bộ Đệm InnoDB Buffer Pool
InnoDB Buffer Pool là trái tim của MySQL: Nơi lưu giữ các trang dữ liệu (Data Pages), trang chỉ mục (Index Pages), bộ đệm thay đổi (Change Buffer) và khóa bản ghi trong bộ nhớ RAM.
graph TD
    subgraph "Hệ Thống Bộ Nhớ InnoDB Buffer Pool (75% RAM Máy Chủ)"
        NEW_SUB["Tiểu Phân Vùng Mới (Young Sublist - 5/8 dung lượng)\nChứa các trang dữ liệu vừa được truy cập liên tục"]
        OLD_SUB["Tiểu Phân Vùng Cũ (Old Sublist - 3/8 dung lượng)\nChứa các trang chuẩn bị bị đẩy ra đĩa (Eviction Candidate)"]
    end

    DISK[("Ổ Cứng NVMe SSD\nTệp bảng .ibd trên đĩa")]

    DISK -->|"Nạp trang mới khi Cache Miss"| OLD_SUB
    OLD_SUB -->|"Truy cập lại sau innodb_old_blocks_time (1.000ms)"| NEW_SUB
    NEW_SUB -->|"Trang bị nguội lạnh dần"| OLD_SUB
    OLD_SUB -->|"Giải phóng trang khi bộ nhớ đầy"| DISK
Đo Lường Tỷ Lệ Hit Rate Của Buffer Pool
Nếu tỷ lệ Hit Rate giảm xuống dưới 95%, hệ thống đang bị nghẽn đĩa I/O nghiêm trọng:
-- Kiểm tra tỷ lệ trúng cache của InnoDB Buffer Pool
SELECT
  (1 - (Innodb_buffer_pool_reads / Innodb_buffer_pool_read_requests)) * 100
  AS buffer_pool_hit_rate_pct
FROM information_schema.GLOBAL_STATUS
WHERE Variable_name IN ('Innodb_buffer_pool_reads', 'Innodb_buffer_pool_read_requests');
Trong MySQL 8.0+, bạn có thể mở rộng kích thước Buffer Pool động mà không cần khởi động lại máy chủ:
-- Mở rộng kích thước Buffer Pool lên 32GB không downtime
SET GLOBAL innodb_buffer_pool_size = 32 * 1024 * 1024 * 1024;
3. Giai Đoạn 2: Chẩn Đoán Truy Vấn Chậm & Triệt Tiêu Deadlocks
Trước khi đầu tư tiền mua thêm máy chủ, hãy dùng công cụ chuyên dụng pt-query-digest của Percona để phát hiện các câu lệnh gây lãng phí tài nguyên:
# Phân tích slow log trên máy chủ phụ trợ (không chạy trực tiếp trên Production)
pt-query-digest /var/log/mysql/slow.log > slow_analysis_report.txt
Xử Lý Tranh Chấp Khóa (Deadlock Mitigation)
Trong các ứng dụng thương mại điện tử, hai tiến trình cùng cập nhật giỏ hàng và trừ tồn kho theo thứ tự ngược nhau sẽ gây ra lỗi ERROR 1213 (40001): Deadlock found when trying to get lock; try restarting transaction.
sequenceDiagram
    autonumber
    participant Tx1 as Giao Dịch 1 (User A)
    participant LockMgr as Bộ Quản Lý Khóa InnoDB
    participant Tx2 as Giao Dịch 2 (User B)

    Tx1->>LockMgr: Khóa Đơn Hàng #101: UPDATE orders WHERE id=101
    LockMgr-->>Tx1: ✅ Cấp khóa độc quyền (Exclusive Lock)

    Tx2->>LockMgr: Khóa Đơn Hàng #102: UPDATE orders WHERE id=102
    LockMgr-->>Tx2: ✅ Cấp khóa độc quyền (Exclusive Lock)

    rect rgb(255, 230, 230)
        Tx1->>LockMgr: Cố gắng khóa Đơn Hàng #102: UPDATE orders WHERE id=102
        Note over Tx1, LockMgr: Tx1 bị chặn (Chờ Tx2 giải phóng #102)

        Tx2->>LockMgr: Cố gắng khóa Đơn Hàng #101: UPDATE orders WHERE id=101
        Note over Tx2, LockMgr: ❌ XUNG ĐỘT VÒNG TRÒN (DEADLOCK CYCLE PHÁT HIỆN)!
        LockMgr-->>Tx2: Hủy bỏ Tx2: ROLLBACK (Error 1213)
        LockMgr-->>Tx1: Cấp khóa #102 cho Tx1 (Tiếp tục thực thi)
    end
4. Giai Đoạn 3: Kiến Trúc Phân Tách Đọc/Ghi Với ProxySQL
Khi lưu lượng đọc vượt quá 1.500 TPS, triển khai ProxySQL làm tầng trung gian cân bằng tải:
flowchart TD
    APP["Tầng Ứng Dụng Go Microservices"] -->|Kết Nối Cổng :6033| PROXY["Cụm ProxySQL Cân Bằng Tải\n(Connection Multiplexing)"]

    subgraph "Bộ Quy Tắc Định Tuyến (Query Rules)"
        R1{"Câu Lệnh Nằm Trong Giao Dịch Mở?\n(transaction_persistent = 1)"}
        R2{"Câu Lệnh SELECT Bình Thường?"}
    end

    PROXY --> R1
    R1 -- CÓ --> MASTER[("MySQL Master (Hostgroup 10 - GHI)")]
    R1 -- KHÔNG --> R2
    R2 -- CÓ --> REPLICAS[("Cụm MySQL Replicas (Hostgroup 20 - ĐỌC)")]
    R2 -- KHÔNG (INSERT/UPDATE) --> MASTER
Cấu Hình ProxySQL Bắt Buộc: transaction_persistent = 1
Nếu không bật cờ transaction_persistent = 1, một câu lệnh SELECT nằm giữa cặp BEGIN ... COMMIT có thể bị ProxySQL đẩy nhầm sang Read Replica, dẫn tới hiện tượng đọc phải dữ liệu cũ vừa mới được tạo ra trên Master trong cùng một phiên giao dịch!
-- Cấu hình trên giao diện Admin của ProxySQL (:6032)
INSERT INTO mysql_users (username, password, default_hostgroup, transaction_persistent)
VALUES ('ecommerce_user', 'secret_pass', 10, 1);
LOAD MYSQL USERS TO RUNTIME;
SAVE MYSQL USERS TO DISK;
5. Cài Đặt Mã Nguồn Production: Go GORM Manager Với Deadlock Retry & Primary-Replica Routing
Dưới đây là mã nguồn Golang 1.24+ triển khai Database Connection Manager chuẩn mực sử dụng thư viện GORM. Mã nguồn tích hợp plugin dbresolver để phân tách đường Đọc/Ghi và cài đặt hàm bọc giao dịch tự động thử lại khi gặp lỗi Deadlock với thuật toán Exponential Backoff có Jitter:
// Package dbmanager triển khai kết nối MySQL chuẩn Production với GORM.
// Hỗ trợ tự động phân tách Đọc/Ghi và cơ chế tự động thử lại khi gặp Deadlock (Error 1213).
package dbmanager

import (
	"context"
	"errors"
	"fmt"
	"log"
	"math/rand"
	"time"

	"github.com/go-sql-driver/mysql"
	gormmysql "gorm.io/driver/mysql"
	"gorm.io/gorm"
	"gorm.io/gorm/logger"
	"gorm.io/plugin/dbresolver"
)

type Config struct {
	PrimaryDSN  string
	ReplicaDSNs []string
	MaxOpenConn int
	MaxIdleConn int
}

type DBManager struct {
	db *gorm.DB
}

func NewDBManager(cfg Config) (*DBManager, error) {
	gormConfig := &gorm.Config{
		Logger: logger.Default.LogMode(logger.Warn),
		NowFunc: func() time.Time {
			return time.Now().UTC()
		},
	}

	// 1. Mở kết nối chính tới Primary (Writer)
	db, err := gorm.Open(gormmysql.Open(cfg.PrimaryDSN), gormConfig)
	if err != nil {
		return nil, fmt.Errorf("không thể kết nối MySQL Primary: %w", err)
	}

	// 2. Cấu hình DBResolver để phân luồng Replicas (Readers)
	var replicaDialectors []gorm.Dialector
	for _, dsn := range cfg.ReplicaDSNs {
		replicaDialectors = append(replicaDialectors, gormmysql.Open(dsn))
	}

	resolverCfg := dbresolver.Config{
		Sources:  []gorm.Dialector{gormmysql.Open(cfg.PrimaryDSN)},
		Replicas: replicaDialectors,
		Policy:   dbresolver.RandomPolicy{}, // Cân bằng tải ngẫu nhiên trên các Replicas
	}

	err = db.Use(dbresolver.Register(resolverCfg).
		SetConnMaxLifetime(30 * time.Minute).
		SetConnMaxIdleTime(5 * time.Minute).
		SetMaxIdleConns(cfg.MaxIdleConn).
		SetMaxOpenConns(cfg.MaxOpenConn))

	if err != nil {
		return nil, fmt.Errorf("cấu hình dbresolver thất bại: %w", err)
	}

	log.Println("✅ Khởi tạo thành công kết nối MySQL với phân tách Đọc/Ghi tự động!")
	return &DBManager{db: db}, nil
}

// ExecuteTxWithDeadlockRetry thực thi giao dịch có cơ chế tự động thử lại khi gặp Deadlock (Mã 1213)
func (m *DBManager) ExecuteTxWithDeadlockRetry(ctx context.Context, maxRetries int, fn func(tx *gorm.DB) error) error {
	var err error

	for attempt := 1; attempt <= maxRetries; attempt++ {
		// Bắt buộc giao dịch chạy trên Primary (Clauses dbresolver.Write)
		err = m.db.WithContext(ctx).Clauses(dbresolver.Write).Transaction(fn)
		if err == nil {
			return nil
		}

		// Kiểm tra mã lỗi Deadlock của MySQL Driver (Error 1213)
		var mysqlErr *mysql.MySQLError
		if errors.As(err, &mysqlErr) && mysqlErr.Number == 1213 {
			jitter := time.Duration(rand.Intn(40)) * time.Millisecond
			sleepDuration := time.Duration(attempt*80)*time.Millisecond + jitter
			log.Printf("⚠️ Phát hiện MySQL Deadlock (Lần thử %d/%d). Đang thử lại sau %v...",
				attempt, maxRetries, sleepDuration)

			select {
			case <-ctx.Done():
				return ctx.Err()
			case <-time.After(sleepDuration):
				continue
			}
		}

		// Nếu là lỗi nghiệp vụ hoặc lỗi khác, dừng ngay lập tức
		return err
	}

	return fmt.Errorf("giao dịch thất bại sau %d lần thử do Deadlock liên tục: %w", maxRetries, err)
}

func (m *DBManager) DB() *gorm.DB {
	return m.db
}
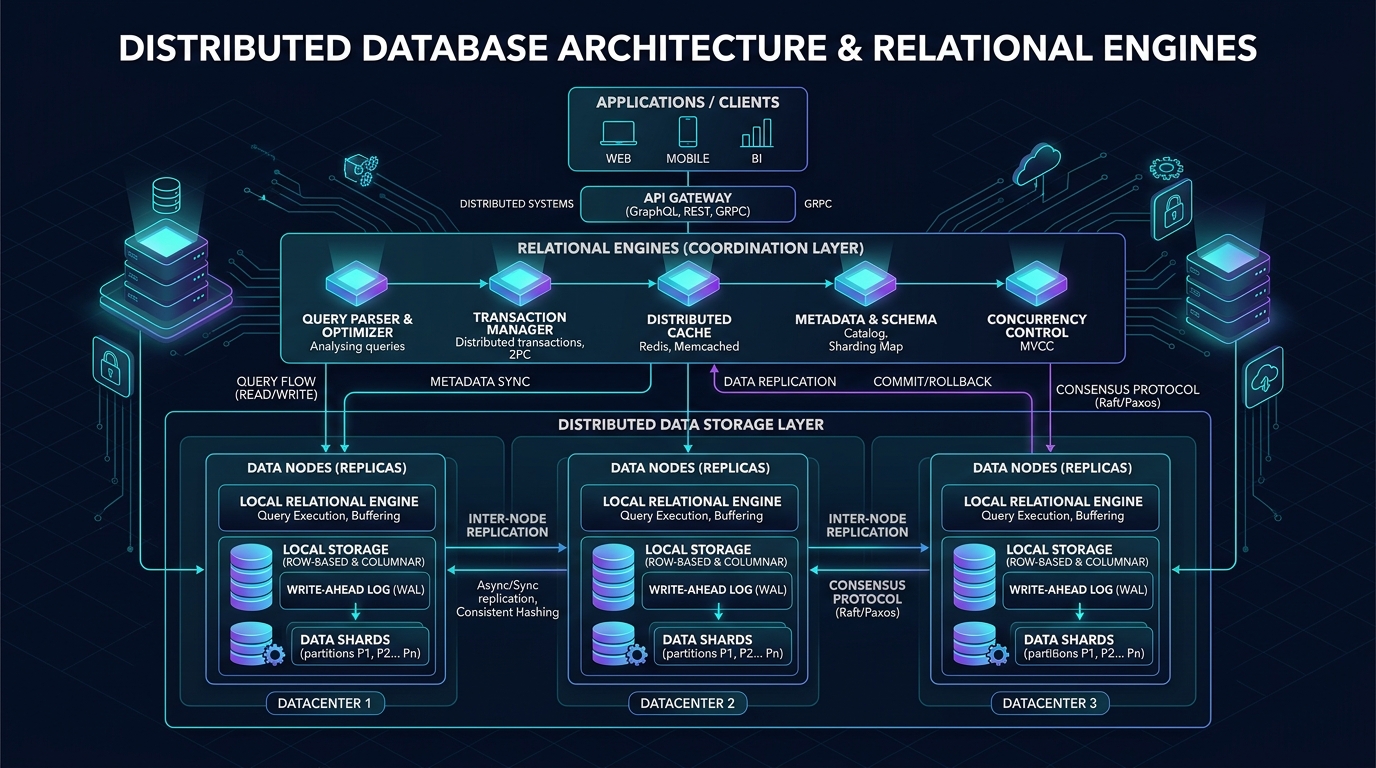
6. Giai Đoạn 4: Khi Nào Bắt Buộc Phải Chuyển Sang TiDB NewSQL?
Khi dung lượng của một bảng đơn lẻ vượt quá 50 triệu bản ghi hoặc kích thước bảng vượt quá 500GB, việc chạy các lệnh ALTER TABLE để thêm cột sẽ trở thành một cơn ác mộng có thể làm treo database trong hàng giờ. Đây là lúc kiến trúc truyền thống chạm trần và buộc phải nâng cấp lên TiDB:
graph LR
    subgraph "Dấu Hiệu Chạm Trần Kiến Trúc MySQL"
        S1["Tải Ghi IOPS đạt 100% đĩa NVMe Master"]
        S2["Replication Lag vượt quá 10 phút"]
        S3["Kích thước bảng > 500GB, không thể đánh index mới"]
    end

    subgraph "Chuyển Đổi Sang TiDB NewSQL"
        TIDB["Cụm TiDB Distributed SQL\n(Stateless SQL + Multi-Raft TiKV)"]
    end

    S1 & S2 & S3 -->|Di Trú Không Downtime| TIDB
7. Di Trú Dữ Liệu Thực Tế Không Downtime Sang TiDB Bằng TiDB DM & Dumpling
Quy trình chuyển đổi từ MySQL sang TiDB cho hệ thống đang phục vụ hàng triệu người dùng trực tuyến yêu cầu độ an toàn tuyệt đối với chiến lược Zero-Downtime Migration:
sequenceDiagram
    autonumber
    participant MySQL as MySQL Master (Production)
    participant DM as TiDB Data Migration (DM)
    participant TiDB as TiDB Cluster (NewSQL)
    participant Diff as sync-diff-inspector
    participant App as Go Backend Services

    Note over MySQL, TiDB: Giai đoạn 1: Full Data Dump & Real-time CDC Sync
    MySQL->>DM: Dumpling xuất toàn bộ dữ liệu Snapshot
    DM->>TiDB: Nạp dữ liệu Snapshot vào TiKV
    DM->>MySQL: Đọc Binary Log thời gian thực (CDC Sync)
    DM->>TiDB: Replicate liên tục các bản ghi mới (Lag < 1s)

    Note over MySQL, Diff: Giai đoạn 2: Đối soát dữ liệu song song (Reconciliation)
    Diff->>MySQL: Quét Checksum bảng dữ liệu
    Diff->>TiDB: Quét Checksum bảng dữ liệu tương ứng
    Diff-->>App: Báo cáo: 100% Dữ liệu khớp tuyệt đối ✅

    Note over App, TiDB: Giai đoạn 3: Bật Dual-Write & Cắt chuyển luồng Traffic
    App->>App: Bật cờ Feature Flag: Dual-Write MySQL + TiDB
    App->>TiDB: Chuyển 100% Read Traffic sang TiDB
    App->>TiDB: Chuyển 100% Write Traffic sang TiDB
    Note over MySQL: Ngắt kết nối MySQL cũ an toàn!
- Giai đoạn Snapshot: Sử dụng công cụ
dumplingđể xuất toàn bộ cơ sở dữ liệu MySQL mà không khóa bảng nhờ cơ chế MVCC nhất quán. - Giai đoạn CDC đồng bộ thời gian thực:
TiDB Data Migration (DM)đọc binlog từ MySQL master và đẩy liên tục sang TiDB với độ trễ dưới 500ms. - Đối soát Checksum: Chạy công cụ
sync-diff-inspectorcủa PingCAP để so sánh hash checksum của từng phân vùng dữ liệu giữa MySQL và TiDB, đảm bảo 0 sai lệch. - Cắt chuyển Cutover: Chuyển đổi endpoint kết nối của Go microservices sang TiDB proxy trong vòng 30 giây bảo trì hoặc thông qua feature flag.
8. Bảng So Sánh Benchmark & Chi Phí (TCO) Giữa 4 Kiến Trúc Mở Rộng
| Tiêu Chí Kỹ Thuật | Single Node NVMe | Master-Replica + ProxySQL | Vitess Sharded MySQL | TiDB NewSQL Cluster |
|---|---|---|---|---|
| Giới hạn Ghi tối đa (Peak Write TPS) | ~800 TPS | ~1.200 TPS | 25.000+ TPS | 100.000+ TPS |
| Giới hạn Đọc tối đa (Peak Read QPS) | ~3.000 QPS | ~35.000 QPS | 150.000+ QPS | 300.000+ QPS |
| Độ trễ P99 Transaction | 8 ms | 12 ms | 35 ms (Cross-shard: 120ms) | 18 ms (Percolator 2PC) |
| Khả năng Auto-Sharding | Không | Không | Thủ công (VSchema) | Tự động (96MB Regions) |
| Chi phí hạ tầng AWS / tháng | ~$450 | ~$1.250 | ~$4.800 | ~$3.200 |
| Độ phức tạp nhân sự SRE (FTE) | 0.1 FTE | 0.3 FTE | 1.5 FTE | 0.5 FTE |
9. 5 Quy Tắc Vàng Khi Thiết Kế B+Tree Indexes Trong MySQL 8.0/8.4
- Tuân thủ Leftmost Prefix Rule: Nếu tạo composite index
(status, created_at, user_id), câu query cóWHERE created_at = ...sẽ không thể tận dụng index này. - Khai thác triệt để Covering Index: Đảm bảo tất cả các cột được
SELECTđều nằm trong B+Tree Index để tránh việc phải tra cứu ngược lại bảng dữ liệu trên đĩa (tránh thao tácClustered Index Lookup/Bookmark Lookup). - Sử dụng Index Condition Pushdown (ICP): MySQL 8.0 tự động đẩy các điều kiện lọc xuống thẳng storage engine InnoDB, giúp giảm số lượng hàng phải trả về cho SQL layer.
- Ứng dụng Functional Indexes cho cột biểu thức: Trong MySQL 8.0+, bạn có thể tạo index trực tiếp trên hàm xử lý dữ liệu (ví dụ:
CREATE INDEX idx_order_year ON orders ((YEAR(created_at)));) mà không cần tạo thêm cột ảo. - Dọn dẹp Unused Indexes bằng
sys.schema_unused_indexes: Mỗi index thừa làm chậm thao tácINSERT/UPDATEđi 10%–15%. Hãy định kỳ kiểm tra và xóa bỏ các index không còn phát sinh truy vấn.
10. Các Câu Hỏi Thường Gặp (FAQ)
Làm thế nào để biết chính xác thời điểm MySQL cần nâng cấp từ Single Node sang Cluster?
max_connections, khiến các ứng dụng nhận lỗi Too many connections.Tại sao câu lệnh SELECT bên trong một Transaction lại bị đọc phải dữ liệu cũ nếu dùng ProxySQL?
transaction_persistent = 1 cho tài khoản người dùng, cơ chế phân tích cú pháp của ProxySQL sẽ mặc định định tuyến tất cả các câu lệnh bắt đầu bằng SELECT sang nhóm máy chủ Replicas (Hostgroup Đọc). Nếu bản sao đang bị trễ sao chép (Replication Lag), nó sẽ trả về dữ liệu cũ mà không phản ánh các lệnh INSERT/UPDATE vừa thực hiện trong transaction trước đó.MySQL 8.4 LTS mang lại những cải tiến gì vượt trội cho việc mở rộng hệ thống?
binlog_transaction_dependency_tracking = 'WRITESET'). Cải tiến này cho phép máy chủ Replica tự động phân tích và áp dụng đồng thời hàng chục giao dịch không xung đột khóa, giúp triệt tiêu gần như hoàn toàn hiện tượng Replication Lag trong các hệ thống có lưu lượng ghi lớn.Sự khác biệt cốt lõi giữa Sharding bằng Vitess và di trú sang TiDB là gì?
Làm sao để hạn chế hiện tượng Deadlock khi cập nhật số lượng tồn kho trong các đợt Flash Sale?
sku_id trước khi thực thi UPDATE; (2) Áp dụng cơ chế kiểm soát đồng thời lạc quan (OCC) với trường version thay vì dùng lệnh khóa bi quan SELECT ... FOR UPDATE; (3) Chuyển toàn bộ tác vụ giữ chỗ tồn kho sang bộ nhớ đệm phân tán Redis thông qua các đoạn mã Atomic Lua Script.🔗 Đọc thêm các chuyên đề & Series liên quan:
- Phình To Cục MySQL: Mổ Kiến Trúc Sharding Cùng TiDB
- Kiến Trúc PayPay: Bung Rộng Hệ Thống Thanh Toán Lên 70 Triệu User
- Kiến Trúc Shopee Flash Sale: Xử Lý Triệu Yêu Cầu Đồng Thời
- Các Mẫu Goroutine Pool Trong Go: Từ errgroup Đến Bounded Worker Pool