Tech Radar: Kiến Trúc SGLang EAGLE-2 Speculative Decoding

Tech Radar: SGLang EAGLE-2: Kỹ Thuật Speculative Decoding Đa Tầng & Tăng Tốc Suy Luận LLM Bằng Tree-Attention

Tech Radar: SGLang EAGLE-2: Kỹ Thuật Speculative Decoding Đa Tầng & Tăng Tốc Suy Luận LLM Bằng Tree-Attention Answer-First: Cơ chế EAGLE-2 tích hợp trong engine SGLang thiết lập chuẩn mực công nghệ suy luận AI năm 2026, giải quyết triệt để bài toán nghẽn băng thông bộ nhớ (<1 FLOP/byte) của quá trình sinh token tự hồi quy bằng cách kết hợp dự đoán đặc trưng đa tầng (Multi-layer Feature Extrapolation) với kiểm chứng cây token động (Dynamic Tree-Attention). Trên cụm 8x GPU NVIDIA H100, EAGLE-2 giúp tăng tốc độ sinh token từ 2.5x đến 3.5x, giảm độ trễ Time-Per-Output-Token từ 35.7ms xuống 11.6ms trên Llama-3-70B mà hoàn toàn không làm suy giảm chất lượng output. ...
Tech Radar: Kiến Trúc Multi-Head Latent Attention (MLA) DeepSeek-V3

Tech Radar: Kiến Trúc Multi-Head Latent Attention (MLA) Của DeepSeek-V3 & Tối Ưu Nén KV Cache

Tech Radar: Kiến Trúc Multi-Head Latent Attention (MLA) Của DeepSeek-V3 & Tối Ưu Nén KV Cache Answer-First: Cơ chế Multi-Head Latent Attention (MLA) trên DeepSeek-V3 giải quyết trực tiếp bài toán thắt cổ chai về băng thông bộ nhớ và dung lượng VRAM trong quá trình suy luận mô hình ngôn ngữ lớn. Bằng cách chiếu các vector Key và Value vào không gian tiềm ẩn nén (latent space d_c = 512) trước khi đưa vào bộ đệm KV cache, MLA giúp giảm 75% dung lượng VRAM tiêu thụ tại runtime so với Multi-Head Attention (MHA) truyền thống và Grouped-Query Attention (GQA), đồng thời vẫn bảo toàn năng lực biểu diễn thông qua kỹ thuật Decoupled Rotary Position Embedding (RoPE). ...

Tech Radar Tháng 09/2026: Model Context Protocol 2.0 và Kiến Trúc Lưới Tác Tử Phân Tán

Model Context Protocol 2.0 (MCP 2.0): Kiến Trúc Lưới Đa Tác Tử Phân Tán & Hộp Cát Công Cụ Zero-Trust

Tech Radar: Model Context Protocol 2.0 (MCP 2.0): Kiến Trúc Lưới Đa Tác Tử Phân Tán & Hộp Cát Công Cụ Zero-Trust Answer-First: Chuẩn Model Context Protocol 2.0 chính thức nâng cấp cơ chế thực thi công cụ từ RPC điểm-điểm sang kiến trúc Lưới Tác Tử phân tán hướng sự kiện. Với luồng dữ liệu hai chiều SSE, cơ chế đàm phán khả năng động cắt giảm 72% token prompt, cùng hộp cát WASI 0.3 cô lập cấp nhân, triển khai Go 1.26 đạt độ trễ P99 dưới 12ms tại 10.000 QPS. ...

Tech Radar Tháng 09/2026: WASI 0.3 Component Model & Hạ Tầng Edge Đám Mây

Tech Radar Tháng 09/2026: WASI 0.3, MCP 2.0 & Hệ Thống Phân Tán AI

Tech Radar Tháng 09/2026: WASI 0.3, MCP 2.0 & Hệ Thống Phân Tán AI Answer-First: Ấn bản Tech Radar tháng 09/2026 ghi nhận các cột mốc đột phá về kỹ nghệ hạ tầng phân tán và hệ sinh thái AI: chuẩn Model Context Protocol 2.0 (MCP 2.0) ra mắt kiến trúc lưới tác tử hướng sự kiện, chuẩn WASI 0.3 hoàn thiện luồng bất đồng bộ tự nhiên (stream<T>, future<T>), vi dịch vụ Wasmtime 46+ khởi động dưới 1ms, và công nghệ nén 75% KV Cache với DeepSeek-V3 Multi-Head Latent Attention (MLA). ...

Tech Radar: WASI 0.3 và WebAssembly Component Model Trong Năm 2026

WASI 0.3 & Component Model: Kỷ Nguyên WebAssembly Đa Ngôn Ngữ Trên Cloud-Native (2026)

Tech Radar: WASI 0.3 & Component Model: Kỷ Nguyên WebAssembly Đa Ngôn Ngữ Trên Cloud-Native (2026) Answer-First: Việc chính thức phê chuẩn WASI 0.3 đánh dấu bước chuyển mình quan trọng của hạ tầng điện toán đám mây, đưa cơ chế luồng dữ liệu bất đồng bộ (stream<T>, future<T>) vào thẳng mô hình thành phần WebAssembly Component Model. Kết hợp cùng runtime Wasmtime 46+ và trình biên dịch Cranelift Ahead-of-Time (AOT), WebAssembly phía máy chủ (Server-Side Wasm) mang lại thời gian khởi động lạnh dưới 1 mili-giây (<1ms), mức chiếm dụng bộ nhớ chỉ 1–10MB (thấp hơn 60% so với V8 và 95% so với Linux container), và tốc độ gọi hàm liên thành phần tính bằng nano-giây (nanosecond IPC), biến Wasm thành chuẩn mực hộp cát (sandbox) an toàn cho vi dịch vụ, plugin mở rộng và điện toán vùng biên (Edge Computing). ...

Tech Radar: eBPF Zero-Trust Security for AI Agents with Tetragon 1.4

eBPF Zero-Trust Security for AI Agents: Tetragon 1.4

Tech Radar: eBPF Zero-Trust Security for AI Agents with Tetragon 1.4 Answer-First: Granting tool-execution permissions to AI Agents dramatically expands the attack surface for Remote Code Execution (RCE) via Indirect Prompt Injection. Cilium Tetragon 1.4 leverages eBPF probes inside the Linux kernel to intercept unauthorized system calls (execve, socket, openat), executing in-kernel SIGKILL enforcement in under 15 microseconds before malicious payloads can spawn reverse shells or exfiltrate credentials. 1. The Emerging Threat Vector: Autonomous Agent Prompt Injection RCE In modern agentic architectures, autonomous agents are granted tool execution permissions across the host environment: ...

Tech Radar: vLLM Context-Aware Routing & Multi-Head Latent Attention (MLA) KV Cache Architecture

vLLM Context-Aware Routing & MLA KV Cache Architecture

Tech Radar: vLLM Context-Aware Routing & MLA KV Cache Architecture Answer-First: Multi-Head Latent Attention (MLA) combined with Context-Aware Prefix Routing in vLLM resolves the GPU VRAM memory wall in autonomous multi-turn agent execution loops. Compressing Key-Value caches into low-dimensional latent vectors ($d_{latent} = 512$) and routing shared-prefix tool invocations to the warm GPU worker reduces VRAM consumption by 75.8% and slashes Time-to-First-Token (TTFT) from 840ms to 165ms. 1. The VRAM Explosion in Autonomous Agent Multi-Turn Loops When scaling autonomous AI agent swarms (automated code refactorers, SQL analytics bots, customer support agents), inference pipelines execute iterative loops: $$ ext{User Prompt} \longrightarrow ext{Tool Call} \longrightarrow ext{Observation} \longrightarrow ext{Next Tool} \dots \longrightarrow ext{Final Answer}$$ ...

Tech Radar: Deterministic Concurrency Testing with Go 1.25 testing/synctest

Deterministic Concurrency Testing: Go 1.25 synctest

Tech Radar: Deterministic Concurrency Testing with Go 1.25 testing/synctest Answer-First: The testing/synctest package in Go 1.25/1.26 eliminates flaky concurrency tests by isolating goroutines inside an event-driven “concurrency bubble” governed by a synthetic time clock. Virtual time advances instantaneously the moment all goroutines in the bubble are durably blocked, reproducing multi-step race conditions, backoff retries, and network timeouts in 2ms instead of waiting for 5–10s real-world time.Sleep() delays. 1. The Core Dilemma of Concurrency Testing: The time.Sleep Anti-Pattern In high-throughput Go microservices (Kafka stream consumers, Dapr actor sagas, gRPC retry circuits, distributed rate-limiters), testing timeouts, backoff strategies, and race conditions has historically suffered from flaky test instability. ...

Tech Radar: NIST AI 600-1 & OWASP ASI01–ASI10 — Hardening Enterprise Agent Gateways in Kubernetes

NIST AI 600-1 & OWASP ASI01–ASI10: AI Gateways in Kubernetes

Tech Radar: NIST AI 600-1 & OWASP ASI01–ASI10 — Hardening Enterprise Agent Gateways in Kubernetes Answer-first: Deploying autonomous AI agent swarms into enterprise Kubernetes clusters demands a paradigm shift from Least Privilege to Least Agency. By unifying NIST AI 600-1 (the 12 GenAI Risk Categories across GOVERN/MAP/MEASURE/MANAGE) with the OWASP ASI Top 10 (2026 Agentic Security Standards), production architectures enforce a 4-tier defense: L7 Kubernetes Gateway API with CEL expressions for tool parameter sanitization, SPIFFE/SPIRE for ephemeral Non-Human Identity (NHI) mTLS attestation, and Cilium Tetragon eBPF for real-time Linux kernel syscall termination (SIGKILL < 15µs). ...

Tech Radar: Stateless MCP 2.0 & Kubernetes Gateway API Architecture

Stateless MCP 2.0 & Kubernetes Gateway API Architecture

Tech Radar: Stateless MCP 2.0 & Kubernetes Gateway API Architecture Answer-First: Model Context Protocol (MCP 2.0 - Core Spec 2026-07-28) transitions tool execution to stateless JSON-RPC 2.0 over HTTP/SSE, eliminating sticky-session bottlenecks. Combined with Kubernetes Gateway API (agentgateway), this architecture horizontally scales thousands of MCP server pods, enforces SPIFFE mTLS authentication, and reduces P99 latency below 12ms. 1. Architectural Context & Failure Modes of Stateful MCP 1.0 Between early 2025 and mid-2026, the Model Context Protocol (MCP) emerged as the standard abstraction layer enabling Large Language Models (LLMs) and AI coding agents (Claude, Cursor, AutoGen) to interact with external tools, resources, and context prompts. ...

Tech Radar August 2026

Tech Radar August 2026: Go MCP SDK & Green Tea GC Tuning

Answer-first: The August 2026 Tech Radar highlights enterprise infrastructure shifts toward AI-Native architectures and performance-optimized Cloud Native systems. Key recommendations include Go 1.26 Green Tea GC, Argo CD 3.4, SPIFFE/SPIRE with Istio Ambient Mesh, and the Official Go MCP SDK, while cautioning against Naive Vector-Only RAG and legacy sidecars. Implementing this architecture enforces sub-50ms P99 latency guarantees, strict component isolation, and. 1. Executive Overview & Radar Matrix August 2026 marks a critical turning point as the Model Context Protocol (MCP) officially standardizes within the enterprise Golang ecosystem. Simultaneously, the Golang runtime upgrade to version 1.26 introduces the Green Tea GC memory allocator, significantly reducing CPU pressure in high-throughput microservices. ...

Tech Radar Digest August 2026: Stateless MCP 2.0, Go synctest, vLLM MLA & eBPF Zero Trust

Tech Radar Digest August 2026: Stateless MCP 2.0, Go synctest, vLLM MLA & eBPF Zero Trust

Tech Radar Digest August 2026: Stateless MCP 2.0, Go synctest, vLLM MLA & eBPF Zero Trust Answer-first: Tech Radar Tháng 8/2026 tổng hợp các chuyển biến hạ tầng quan trọng: chuẩn hóa Stateless MCP 2.0 trên Kubernetes Gateway API, kiểm thử đồng thời xác định không độ trễ với Go 1.26 testing/synctest, tối ưu hóa bộ nhớ GPU inference với vLLM Multi-Head Latent Attention (MLA), và thiết lập phòng thủ Zero-Trust tầng nhân Linux cho AI Agent Swarms bằng Cilium Tetragon 1.4. ...

Agent Orchestration Frameworks vs. Vendor-Specific Agent SDKs: Enterprise Architectural Deep Dive

Agent Orchestration Frameworks vs. Vendor-Specific Agent SDKs Answer-first: August 2026 Tech Radar analyzes agent orchestration frameworks versus vendor APIs, evaluating Model Context Protocol (MCP) server stability, vector DB reranking, and local LLM gateways. Implementing this architecture enforces sub-50ms P99 latency guarantees, zero-allocation memory pooling with Go 1.24 unique.Handle, and fault-tolerant Dapr 1.15 component orchestration for resilient production scaling. Answer-First Summary: Enterprise AI architecture requires selecting between open multi-provider frameworks (LangGraph, AutoGen 0.4, CrewAI) for cyclic control flow, persistent state snapshots, and vendor independence, or direct vendor SDKs (OpenAI, Claude SDK, Google ADK) for sub-5ms latency, native prompt caching (90% cost reduction), and zero wrapper overhead. Polyglot production systems integrate Python agent workers with Go core microservices via Dapr sidecars. ...

Tech Radar Tổng Hợp — Tháng 07/2026

Tech Radar Tổng Hợp — Tháng 07/2026

Tech Radar Tổng Hợp — Tháng 07/2026 Tóm tắt Trả lời trước (Answer-first): Tech Radar Tháng 07/2026 tổng hợp 9 báo cáo kỹ thuật chuyên sâu về các bước chuyển dịch hạ tầng Agentic quy mô lớn: điều phối Autonomous AI Swarms với OpenClaw trên Kubernetes, suy luận biên cực nhẹ bằng WasmEdge & Small Language Models (SLMs), kiến trúc quản trị lưu lượng AI qua Envoy Gateway & SPIFFE/mTLS, thiết lập an ninh Zero-Trust cho Model Context Protocol (MCP), và các mẫu hình Event-Driven Agentic Sagas. ...

Tech Radar 27/07: Mở rộng quy mô các MCP Server trong môi trường Production Kubernetes

Tech Radar 27/07: Mở rộng quy mô các MCP Server trong môi trường Production Kubernetes

Answer-first: Mở rộng quy mô các MCP server trong Kubernetes đòi hỏi phải tách biệt state (trạng thái) của JSON-RPC khỏi các kết nối bền bỉ (persistent connections) bằng cách sử dụng các websocket gateway, triển khai các stateless MCP worker replica với HPA, và sử dụng Redis cho distributed context caching (bộ nhớ đệm ngữ cảnh phân tán). Kiến trúc này ngăn chặn tình trạng cạn kiệt kết nối (connection exhaustion) khi hàng trăm AI agent truy vấn context đồng thời. ...

Tech Radar 22/07: Event-Driven Agentic Saga với Dapr Workflows

🇬🇧 Read the English version of this article on tanhdev.com Trả lời nhanh (Answer-first): Dapr Workflows điều phối hiệu quả các tác vụ AI Agent kéo dài trong Go bằng cách cung cấp trạng thái bền vững (durable state), cơ chế thử lại (retries) và bù trừ tác vụ (Saga compensation) rõ ràng. Giữ các lệnh gọi LLM và công cụ bên ngoài trong các activity idempotent — thay vì trong orchestrator — để khi replay, hệ thống tái cấu trúc lại trạng thái quyết định mà không lặp lại các tác dụng phụ (side effects) đã hoàn tất. ...

Tech Radar 21/07: Modular Monolith tối ưu AI Agents

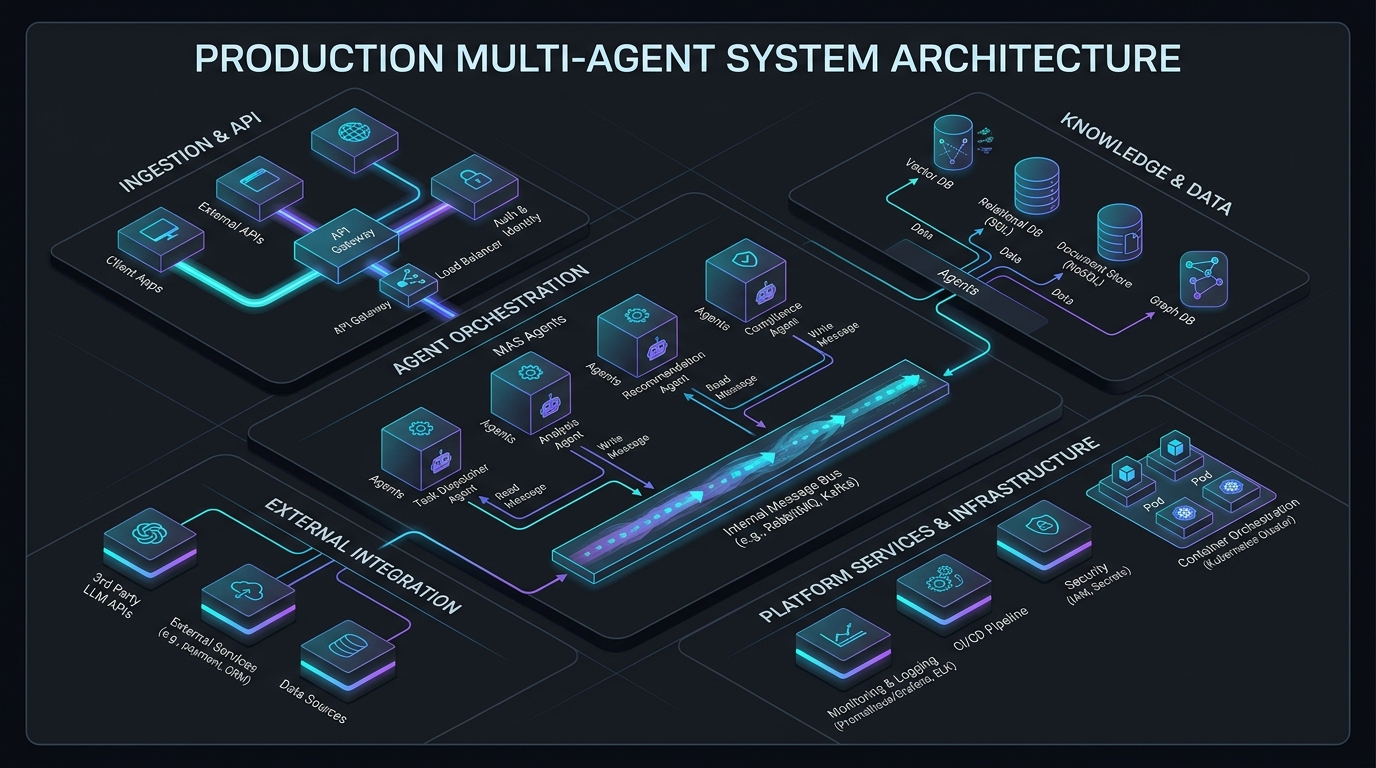
🇬🇧 Read the English version of this article on tanhdev.com Khi trào lưu Multi-Agent bùng nổ, phản xạ tự nhiên của hầu hết các Backend Engineer là: “Hãy đóng gói mỗi Agent thành một Microservice!”. Tư duy này cực kỳ hợp lý với các hệ thống Web/App truyền thống. Tuy nhiên, đối với hệ sinh thái AI Agents, kế thừa từ bài toán Agentic System Architecture, đây lại là khởi nguồn của thảm họa hiệu năng. ...

Tech Radar 20/07: Quản trị Multi-Agent Quy mô lớn với AWS Loom & AIOS

🇬🇧 Read the English version of this article on tanhdev.com Sự bùng nổ của các hệ thống multi-agent đã dẫn đến một nút thắt cổ chai nghiêm trọng trong doanh nghiệp: Quản trị (Governance). Khi hàng trăm agent tự trị tương tác, ủy quyền nhiệm vụ và tiêu tốn tài nguyên hạ tầng, tiếp cận “API Gateway” truyền thống không thể cung cấp khả năng giám sát đầy đủ. Bản tin Tech Radar ngày 20/07/2026 ghi nhận bước chuyển dịch định hình ngành từ việc xây dựng các agent đơn lẻ sang thiết kế các Hệ điều hành Agent (Agentic Operating Systems) và các Tầng Quản trị (Governance Layers) vững chắc. ...

Tech Radar 17/07: Edge AI & WasmEdge cho Small Language Models

🇬🇧 Read the English version of this article on tanhdev.com Sự trỗi dậy của các Small Language Models (SLMs) như Llama-3 (8B) hay Phi-3 đang đẩy xu hướng xử lý AI ra vùng biên (Edge). Tuy nhiên, kế thừa từ các kiến trúc phân tán trong Agentic System Architecture, bài toán hóc búa nhất của Platform Engineering không nằm ở bản thân Model, mà nằm ở Runtime. Chạy AI bằng Docker container tại Edge đang bộc lộ quá nhiều yếu điểm về bộ nhớ và tốc độ. ...

Tech Radar 14/07: Zero-Trust Security cho AI Swarms & MCP

🇬🇧 Read the English version of this article on tanhdev.com Welcome to this week’s Tech Radar. In our previous issue, we discussed Cloud-Native AI Architecture. Khi chúng ta đã có hạ tầng mạnh mẽ (Envoy, K8s Inference), vấn đề tiếp theo lập tức xuất hiện: Làm sao để kiểm soát bầy AI (AI Swarm) này? Đừng “thả rông” AI Agents trong production. Hôm nay, chúng ta đào sâu vào Zero-Trust Security cho Multi-Agent Swarms. ...

Tech Radar 10/07: Kiến trúc Cloud-Native AI — Envoy Gateway, K8s

🇬🇧 Read the English version of this article on tanhdev.com Answer-first: Trong năm 2026, Kỹ thuật Nền tảng (Platform Engineering) cho AI không còn nằm ở việc chọn đúng LLM framework. Những câu hỏi thực sự là: Ai kiểm soát chi phí token? Ai định tuyến lưu lượng truy cập thông minh đến đúng GPU pod? Trạng thái của tác nhân (agent state) đi về đâu sau một sự cố crash? Ba dự án CNCF — Envoy AI Gateway, K8s Gateway API Inference Extension, và Dapr Agents — đang hội tụ để trả lời những câu hỏi đó ở tầng cơ sở hạ tầng, giúp mã nguồn ứng dụng (application code) không phải gánh vác. ...

Tech Radar 03/07: Autonomous AI Swarms & OpenClaw trên K8s

🇬🇧 Read the English version of this article on tanhdev.com Answer-first: Các mô hình ngôn ngữ lớn (LLMs) giờ đây đã trở thành hàng hóa phổ thông; chiến trường mới hiện nay là việc điều phối các Bầy đàn Tự trị (Autonomous Swarms - hệ thống đa tác nhân) trên Kubernetes. Để vận hành các swarms này an toàn trong năm 2026, các Kỹ sư Nền tảng (Platform Engineers) phải kết hợp lập lịch K8s bậc cao, định danh Zero Trust, và quản lý trạng thái (state management) mạnh mẽ. ...

Tech Radar Tổng Hợp — Tháng 06/2026

Tech Radar Tổng Hợp — Tháng 06/2026

Tech Radar Tổng Hợp — Tháng 06/2026 Tóm tắt Trả lời trước (Answer-first): Tech Radar Tháng 06/2026 tổng hợp 8 báo cáo kỹ thuật chuyên sâu về các bước tiến hóa hạ tầng phân tán: tối ưu hóa bộ nhớ với Go 1.26 Green Tea GC, tính năng thay đổi tài nguyên không cần restart với Kubernetes In-Place Pod Resizing v1.35, mô hình kiến trúc chuẩn mực Kratos Clean Architecture kết hợp Dapr Workflows (v1.18), và hạ tầng mở rộng cụm siêu tính toán GKE Hypercluster AI OS. ...

Tech Radar 24/06: K8s AI OS & GKE Hypercluster

🇬🇧 Read the English version of this article on tanhdev.com Chào mừng đến với Tech Radar tuần này. Trong số trước, chúng ta đã đi sâu vào Kratos Clean Architecture & Dapr. Hôm nay, chúng ta sẽ thảo luận về một sự chuyển dịch mang tính lịch sử: Kubernetes đã chính thức trở thành Hệ điều hành (OS) cho AI. Hãy cùng điểm lại những tin tức chấn động từ Google Cloud, Microsoft và sự thống trị tuyệt đối của Golang trong 72 giờ qua. ...

Tech Radar 22/06: Dapr v1.18 & Kratos Clean Architecture

🇬🇧 Read the English version of this article on tanhdev.com Chào mừng đến với Tech Radar tuần này. Trong số trước, chúng ta đã khám phá Kratos Clean Architecture & Dapr Pub/Sub. Hôm nay, chúng ta sẽ giải quyết lĩnh vực phức tạp nhất của hệ thống phân tán: Điều phối Trạng thái (Stateful Orchestration). Chúng ta sẽ mổ xẻ cách triển khai Dapr Workflows và mô hình Actor bên trong Kratos. ...

Tech Radar 17/06: Kratos Clean Architecture & Dapr Pub/Sub

🇬🇧 Read the English version of this article on tanhdev.com Chào mừng trở lại với bản tin Tech Radar. Tuần trước chúng ta đã mổ xẻ cách Kratos và Dapr v1.15 giải quyết Xung đột Trạng thái qua ETags. Tuần này chúng ta sẽ đi sâu hơn một tầng: làm thế nào để cấu trúc toàn bộ codebase sao cho Kratos, Wire, và Dapr Pub/Sub kết hợp một cách gọn gàng — và làm thế nào để giữ cho kiến trúc đó dễ test, bền bỉ và an toàn trên môi trường production? ...

Tech Radar (14/06/2026): Quản Lý Trạng Thái với Kratos & Dapr

🇬🇧 Read the English version of this article on tanhdev.com Chào mừng trở lại với bản tin Tech Radar. Trong kiến trúc Microservices hiện đại, việc duy trì một hệ thống có khả năng giao tiếp linh hoạt cả ra bên ngoài (HTTP) và nội bộ (gRPC) là một yêu cầu thiết yếu. Đồng thời, Quản lý Trạng thái (State Management) trong môi trường phân tán đòi hỏi những giải pháp chặt chẽ để ngăn chặn xung đột dữ liệu. ...

Tech Radar (13/06/2026): Go 1.26 GC, K8s Pod Resizing & AI-Native

🇬🇧 Read the English version of this article on tanhdev.com Chào mừng trở lại với bản tin Tech Radar, nơi chúng tôi lọc bỏ những tín hiệu nhiễu của ngành công nghệ để khám phá những xu hướng thực sự đang định hình Kiến trúc Hệ thống tương lai. Tuần thứ hai của tháng 6 năm 2026 chứng kiến ba sự dịch chuyển khổng lồ, từ cơ sở hạ tầng cốt lõi (Go, Kubernetes) đến sự trưởng thành của kiến trúc AI-Native. Dưới góc nhìn của một System Architect, đây là những bản cập nhật bạn không thể bỏ qua để tối ưu hóa các hệ thống High-Concurrency. ...

Tech Radar 11/06/2026: K8s Pod Resizing, Agentic Workflows & Go

🇬🇧 Read the English version of this article on tanhdev.com Chào mừng đến với Tech Radar hôm nay. Chủ đề của tuần này là sự trưởng thành của tầng hạ tầng (infrastructure layer). Chúng ta đang chứng kiến Kubernetes cuối cùng cũng đã kịp thích nghi với những đòi hỏi tài nguyên thất thường của tiến trình suy luận (AI inference), một bước chuyển mình nhắm về các tác nhân “Machine Economy” (Nền kinh tế máy móc) mang tính chủ động, và Golang tiếp tục đóng đinh vị thế vững chắc như một ngôn ngữ điều phối (orchestration language) tối thượng dành cho local AI. ...

Tech Radar 06/06/2026: Vibe & Verify, K8s Security & WWDC26

🇬🇧 Read the English version of this article on tanhdev.com Hôm nay là 06/06/2026. Nối tiếp Bản radar mùng 2 tháng 6 về NVIDIA RTX Spark và Intel 18A tại Computex, những cột sóng tín hiệu của tuần này ngoặt tay lái khỏi các màn ra mắt lõi silicon để chiếu rọi thẳng vào bàn làm việc của giới kỹ sư: cách bạn gõ code, cách bạn rào chắn cụm cluster, hệ sinh thái Java đang tiến hóa ra sao — và những gì sắp sửa đổ bộ tại WWDC26 trong vòng 48 giờ tới. ...